library(here)
library(agricolae)
library(tidyverse)
library(latex2exp)关于回归和拟合,从它们的求解过程以及结果来看,两者似乎没有太大差别,事实也的确如此。从 本质上说,回归属于数理统计问题,研究解释变量与响应变量之间的关系以及相关性等问题。而 拟合是把平面的一系列点,用一条光滑曲线连接起来,并且让更多的点在曲线上或曲线附近。更 确切的说,拟合是回归用到的一种数学方法,而拟合与回归的应用场合不同。拟 合常用的方法有最小二乘法、梯度下降法、高斯牛顿(即迭代最小二乘)、列-马算法。其 中最最常用的就是最小二乘法。并 且拟合可以分为线性拟合与非线性拟合,非线性拟合比较常用的是多项式拟合。根 据自变量的个数,拟合也可以分为曲线拟合与曲面拟合等。而 回归大多数采用最小二乘法。回 归可以分为一元线性回归、一元非线性回归、多元线性回归、多元非线性回归等。
通常情况下,拟合通常所处理的是一元函数(即曲线拟合),求自变量与因变量之间的关系;对于多元回归问题,一般会涉及很多个解释变量。通 常情况下,我们会把线性回归与线性拟合定义等同。本 文对于回归问题,与拟合方法结合,讲解对于不同情况下拟合方程的求法,对相关系数等知识不做展开。
8.1 线性拟合
线性回归分析的步骤:
- 先假设一个概率模型,这里,我们限定为直线模型y=\beta_0+\beta_1x+\epsilon其中,\beta_0为直线截距,\beta_1为直线斜率,\epsilon为随机误差。
- 利用最小二乘法估计上述模型中的未知数。利用最小二乘法,可以得到一个误差平方和(SSE)比任何其他直线模型的SSE都小的模型\hat{y}=\hat{\beta}_0+\hat{\beta}_1x。指定随机误差分量\epsilon 的概率分布
- E(\epsilon)=0
- 对所有的x值,Var(\epsilon)=\sigma^2为常数
- \epsilon具有正态分布
- \epsilon 是独立的 尽管上述假定不一定完全满足,但一般我们近似认为满足,并用s^2=\frac{SSE}{n-2} 作为\sigma^2的一个无偏估计量,来代替\sigma^2 (这个值也称为均方误差或MSE)
- 评价模型。包括检验斜率\beta_1 为0的原假设(t检验)、斜率的置信区间、计算相关系数(r)、决定系数^+(r^2)
- 如果经过上述步骤,如果对模型比较满意,可以利用给定的x值估计y的均值E(y)或者给出y的预测区间。
下面以R自带数据集Chickweight为例来介绍。该 数据集是有关不同饮食情况下小鸡质量同饲养时间关系的数据记录,共578条。
Chickweight数据集具体数据如 表 8.1 所示:
ChickWeight %>% head(20)| weight | Time | Chick | Diet |
|---|---|---|---|
| 42 | 0 | 1 | 1 |
| 51 | 2 | 1 | 1 |
| 59 | 4 | 1 | 1 |
| 64 | 6 | 1 | 1 |
| 76 | 8 | 1 | 1 |
| 93 | 10 | 1 | 1 |
| 106 | 12 | 1 | 1 |
| 125 | 14 | 1 | 1 |
| 149 | 16 | 1 | 1 |
| 171 | 18 | 1 | 1 |
| 199 | 20 | 1 | 1 |
| 205 | 21 | 1 | 1 |
| 40 | 0 | 2 | 1 |
| 49 | 2 | 2 | 1 |
| 58 | 4 | 2 | 1 |
| 72 | 6 | 2 | 1 |
| 84 | 8 | 2 | 1 |
| 103 | 10 | 2 | 1 |
| 122 | 12 | 2 | 1 |
| 138 | 14 | 2 | 1 |
dt <- ChickWeight %>% group_by(Diet,Time) %>%
  summarise(weight=mean(weight ))

ggplot(dt,aes(x=Time,y=weight,color=Diet))+
  geom_point(aes(shape = Diet))+
  geom_line(aes(linetype = Diet))+
  labs(x="小鸡喂养周数 (w)", y="小鸡质量 (g)")
根据 图 8.1 数据分布情况可以判断,不同食物喂养下小鸡生长曲线存在明显的差异,且线性关系比较好。 我们选择其中Diet=1一条曲线的相关数据进行拟合。
cw.data1 <- ChickWeight |> filter(Diet==1)
cw.data1 %>% head(20)| weight | Time | Chick | Diet |
|---|---|---|---|
| 42 | 0 | 1 | 1 |
| 51 | 2 | 1 | 1 |
| 59 | 4 | 1 | 1 |
| 64 | 6 | 1 | 1 |
| 76 | 8 | 1 | 1 |
| 93 | 10 | 1 | 1 |
| 106 | 12 | 1 | 1 |
| 125 | 14 | 1 | 1 |
| 149 | 16 | 1 | 1 |
| 171 | 18 | 1 | 1 |
| 199 | 20 | 1 | 1 |
| 205 | 21 | 1 | 1 |
| 40 | 0 | 2 | 1 |
| 49 | 2 | 2 | 1 |
| 58 | 4 | 2 | 1 |
| 72 | 6 | 2 | 1 |
| 84 | 8 | 2 | 1 |
| 103 | 10 | 2 | 1 |
| 122 | 12 | 2 | 1 |
| 138 | 14 | 2 | 1 |
简单线性回归分析结果如下:
mdl <- lm(formula =weight~Time+1,data =cw.data1)
# myfun <- \(x)predict(mdl,list(Time=x))
sumres <- mdl %>% summary
sumres
Call:
lm(formula = weight ~ Time + 1, data = cw.data1)

Residuals:
    Min      1Q  Median      3Q     Max
-78.609 -15.677  -0.324  11.069 130.391

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  30.9310     4.0948   7.554 1.15e-12 ***
Time          6.8418     0.3286  20.822  < 2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 32.85 on 218 degrees of freedom
Multiple R-squared:  0.6654,    Adjusted R-squared:  0.6639
F-statistic: 433.5 on 1 and 218 DF,  p-value: < 2.2e-16
根据分析结果,回归曲线拟合效果如下:
ggplot(cw.data1,aes(x=Time,y=weight))+
  geom_point()+
  geom_smooth(method="lm",formula=y~x+1)+
  ggpubr::stat_regline_equation(formula = y~x+1)+
  ggpubr::stat_cor(
   aes(label = paste(after_stat(rr.label), after_stat(p.label), sep = "~`,`~")), vjust=3
)
图 8.2 同时还添加了线性回归方程、可决系数及显著性
8.2 多项式拟合 (广义线性拟合)
仍然以 图 8.2 数据为例,分别进行二次多项式和三次多项式拟合。
ggplot(cw.data1,aes(x=Time,y=weight))+
  geom_point()+
  geom_smooth(method = "lm",
              formula = y ~ poly(x, 2),
              aes(col = "2次项")) +
  ggpubr::stat_regline_equation(formula = y ~ poly(x, 2),
                                aes(col = "2次项"),
                                label.y = 300) +
  ggpubr::stat_cor(aes(
    label = paste(after_stat(rr.label), after_stat(p.label), sep = "~`,`~"),
    col = "2次项"
  ),
  vjust = 1.5,
  label.y = 300)+

  geom_smooth(method = "lm",
              formula = y ~ poly(x, 3),
              aes(col = "3次项"))+
  ggpubr::stat_regline_equation(formula = y ~ poly(x, 3),
                                aes(col = "3次项"),
                                label.y = 270)+
  ggpubr::stat_cor(aes(
    label = paste(after_stat(rr.label), after_stat(p.label), sep = "~`,`~"),
    col = "3次项"
  ),
  vjust = 1.5,
  label.y = 270)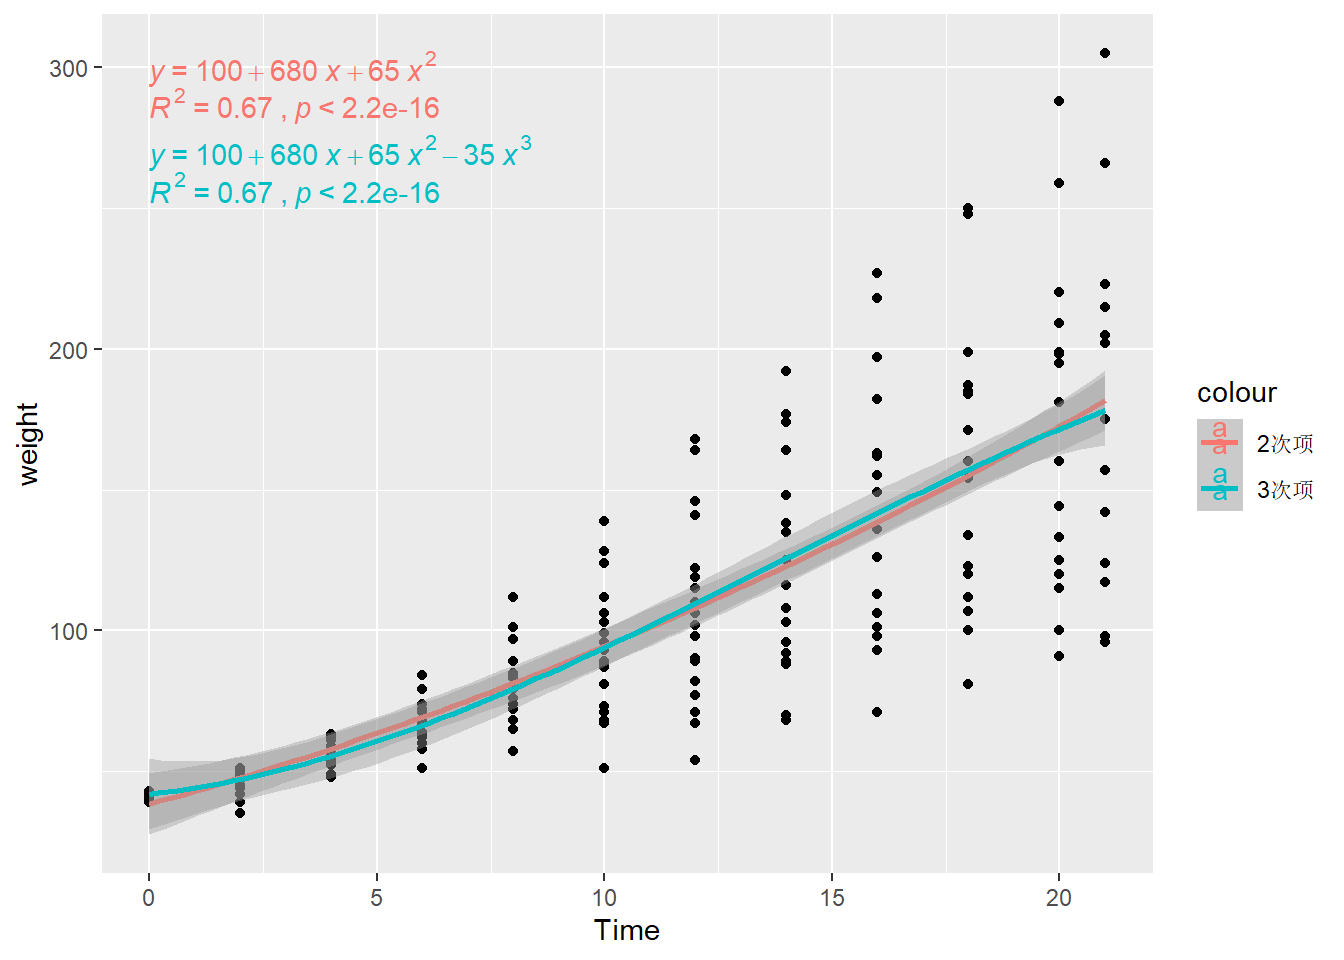
8.3 非线性拟合
以我一个研究生做的高速离心机土壤水分特征曲线数据为例
8.3.1 读取原始数据
dt <- read.csv(here::here("RES/dataset/土壤水分特征曲线.csv"),fileEncoding = "gb2312")
dt| X | trt | omega | theta | f |
|---|---|---|---|---|
| 1 | 空白 | 0 | 0.4533525 | 0.000000 |
| 2 | 空白 | 300 | 0.4512233 | 2.552105 |
| 3 | 空白 | 600 | 0.4408607 | 10.107651 |
| 4 | 空白 | 900 | 0.4287757 | 22.524309 |
| 5 | 空白 | 1500 | 0.4101808 | 61.437503 |
| 6 | 空白 | 2400 | 0.3840277 | 153.539064 |
| 7 | 空白 | 3600 | 0.3567492 | 337.350839 |
| 8 | 空白 | 4500 | 0.3324589 | 518.063136 |
| 9 | 空白 | 6300 | 0.3072966 | 991.002604 |
| 10 | 空白 | 9000 | 0.2828464 | 1981.760845 |
| 21 | 5%稻壳 | 0 | 0.4739078 | 0.000000 |
| 22 | 5%稻壳 | 300 | 0.4730670 | 2.576677 |
| 23 | 5%稻壳 | 600 | 0.4666469 | 10.229789 |
| 24 | 5%稻壳 | 900 | 0.4582204 | 22.813349 |
| 25 | 5%稻壳 | 1500 | 0.4372087 | 62.694019 |
| 26 | 5%稻壳 | 2400 | 0.4052362 | 158.261812 |
| 27 | 5%稻壳 | 3600 | 0.3706382 | 350.924343 |
| 28 | 5%稻壳 | 4500 | 0.3474382 | 541.402949 |
| 29 | 5%稻壳 | 6300 | 0.3249979 | 1036.105165 |
| 30 | 5%稻壳 | 9000 | 0.2960089 | 2073.411950 |
8.3.2 van Genuchten模型
采用著名van Genuchten土壤持水曲线模型(VG模型)进行拟合,具体见 公式 8.1
\theta ( h ) = \left\{ \begin{matrix} \theta _ { r } + \frac { ( \theta _ { s } - \theta _ { r } ) } { ( 1 + | \alpha h | ^ { n } ) ^ { m } },h < 0 \\ \theta _ { s }, h \geq 0 \end{matrix} \right. \tag{8.1}
8.3.3 van Genuchten模型拟合并获取拟合参数
library(minpack.lm)
VG <- function(h,theta_R,theta_S,alpha,n){
  m <- 1-1/n
  sat.index <- (1 + (alpha * h)^n)^(-m)
  theta_R + (theta_S - theta_R) * sat.index
}
dt1 <- dt %>% filter(trt=="空白") %>% select(theta,h=f)
dt2 <- dt %>% filter(trt=="5%稻壳") %>% select(theta,h=f)
fitINFO1 <- nlsLM(theta~VG(h,theta_R, theta_S, alpha, n),data=dt1,
                 start = list(theta_R = 0.02,
                              theta_S = 0.5,
                              alpha=0.005,
                              n=1.0),
                 lower=c(theta_R=0.01,theta_S = 0.40,alpha=0,n=0.5),
                 upper =c(theta_R=0.05,theta_S = 0.6,alpha=1,n=2),
                 control = nls.lm.control(maxiter=10000)
)

fitINFO2 <- nlsLM(theta~VG(h,theta_R, theta_S, alpha, n),data=dt2,
                 start = list(theta_R = 0.02,
                              theta_S = 0.5,
                              alpha=0.005,
                              n=1.0),
                 lower=c(theta_R=0.01,theta_S = 0.40,alpha=0,n=0.5),
                 upper =c(theta_R=0.05,theta_S = 0.6,alpha=1,n=2),
                 control = nls.lm.control(maxiter=10000)
)

coef(fitINFO1) %>% data.frame()
coef(fitINFO2) %>% data.frame()| . | |
|---|---|
| theta_R | 0.0100000 |
| theta_S | 0.4499583 |
| alpha | 0.0183465 |
| n | 1.1317433 |
| . | |
|---|---|
| theta_R | 0.0500000 |
| theta_S | 0.4736644 |
| alpha | 0.0152628 |
| n | 1.1567124 |
8.3.4 根据VG模型拟合参数预测并绘图土壤水分特征曲线
library(latex2exp)
fitINFO1 <- coef(fitINFO1) %>% as.list
fitINFO2 <- coef(fitINFO2) %>% as.list
myFun <- function(h,fitinfo){
  return(VG(h,fitinfo[["theta_R"]],fitinfo[["theta_S"]],fitinfo[["alpha"]],fitinfo[["n"]]))
}

G <- ggplot()+
  geom_point(data = dt1, aes(x = h, y = theta,color="CK"))+
  geom_function(data=dt1, fun = myFun, aes(x = h,color="CK"), args=list(fitinfo = fitINFO1))+

  geom_point(data = dt2, aes(x = h, y = theta,color="5%稻壳"))+
  geom_function(data=dt2, fun = myFun, aes(x = h,color="5%稻壳"), args=list(fitinfo = fitINFO2))+


  labs(y=TeX("含水率 ($cm^{3}~cm^{-3}$)"),x=TeX("土壤基质势 ($-kpa$)"))+
  scale_x_log10(limits=c(1,5000))+
  coord_flip()
G
更具VG模型参数,生成字符串格式VG公式。
getVG_expression <- function(theta_R,theta_S,alpha,n){
  glue::glue("$y ={theta_R} + \\frac {{ ( {round(theta_S,3)}  - {round(theta_R,3)}) }} {{ ( 1 + |{round(alpha,3)}*x| ^{{ {round(n,3)} }}) ^ {{{round(1-1/n,3)} }}}}$") %>%
    TeX() %>% as.character()
}
添加VG模型公式
G+
  geom_text(aes(x=4500,y=0.425,label=getVG_expression(fitINFO1[[1]],fitINFO1[[2]],fitINFO1[[3]],fitINFO1[[4]]),
                color="CK"),parse = TRUE)+
  geom_text(aes(x=1200,y=0.425,label=getVG_expression(fitINFO2[[1]],fitINFO2[[2]],fitINFO2[[3]],fitINFO2[[4]]),
                color="5%稻壳"),parse=TRUE)+
  labs(color="处理")